Le site qui ne montre pas la même page aux robots et aux humains
Même URL, deux documents : une page riche pour les visiteurs humains, une version texte structurée pour les robots des chatbots IA. Comment fonctionne la négociation de contenu, où l'installer, et les pièges à éviter pour que les deux versions restent cohérentes.
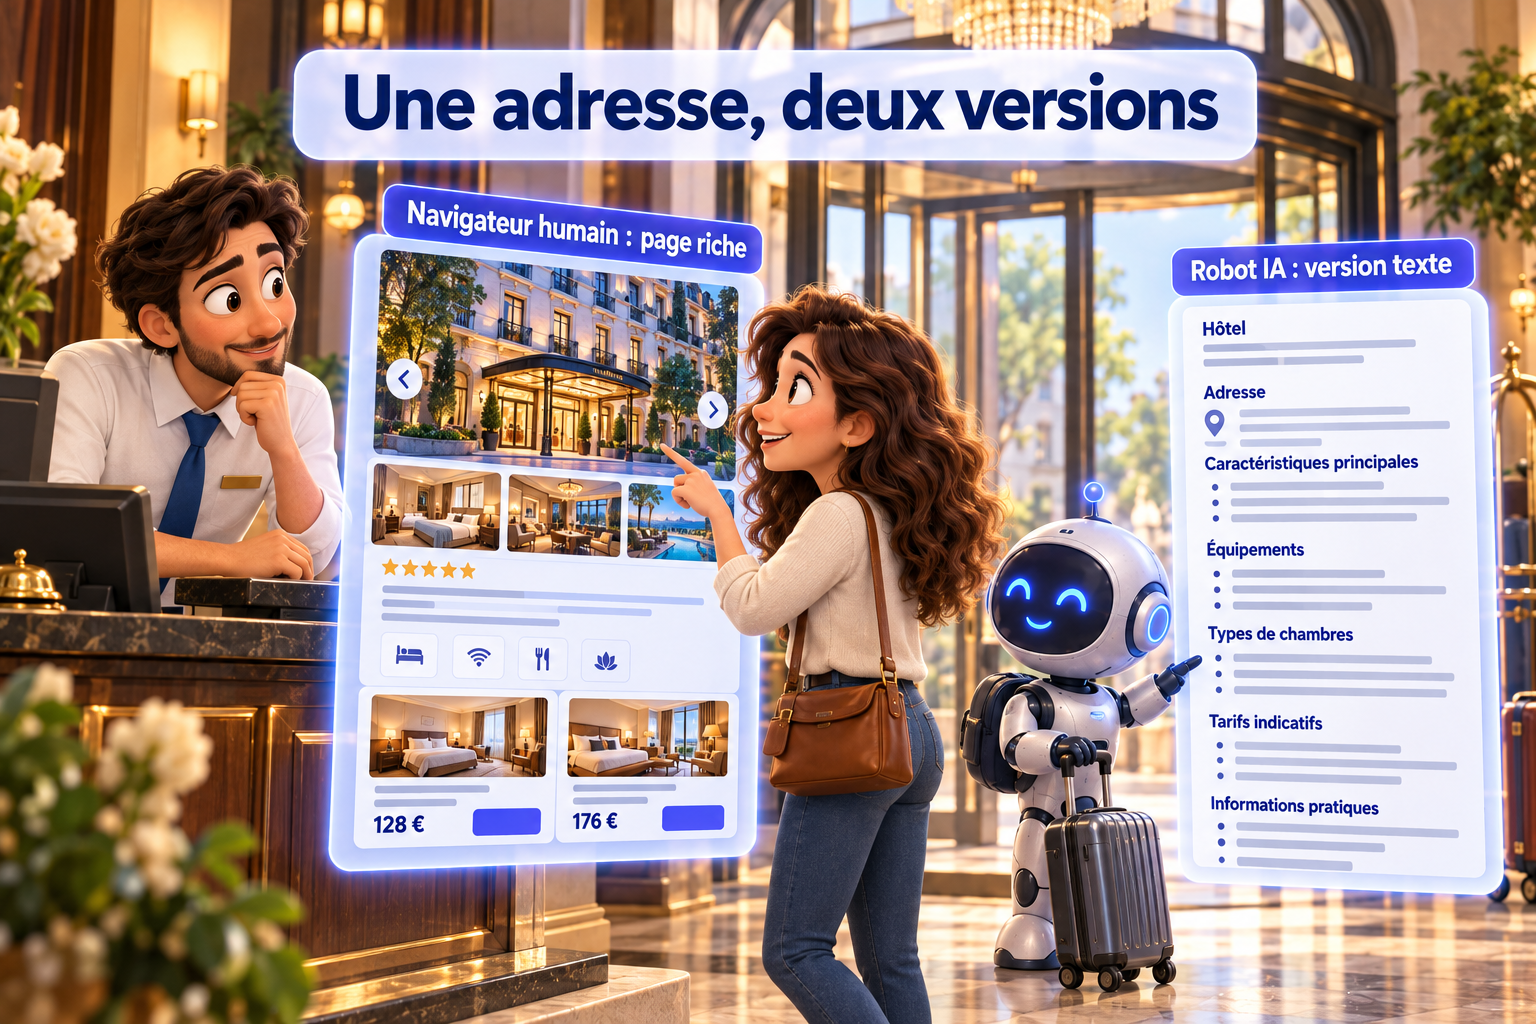
Un visiteur arrive sur une fiche produit. Son navigateur charge une page construite en JavaScript, le langage qui permet d'animer un site, d'afficher un carrousel d'images, de faire apparaître un prix qui change selon la couleur choisie. Trente secondes plus tard, un robot de ChatGPT arrive sur la même adresse. Il ne voit rien de tout ça. Pas de carrousel, pas de prix, parfois une page quasiment vide, parce que ce robot ne reste pas assez longtemps pour laisser le JavaScript s'exécuter et construire la page sous ses yeux. Deux visiteurs, une seule adresse, deux expériences radicalement différentes. C'est là que se joue une bonne partie du GEO, l'optimisation d'un site pour qu'il soit visible et bien cité dans les réponses des chatbots IA comme ChatGPT, Claude, Gemini ou Perplexity, plutôt que dans les liens bleus de Google.
La solution qui s'impose en ce moment n'est ni de tout bloquer, ni de tout ouvrir en grand. Elle consiste à faire quelque chose de plus subtil : montrer un visage différent selon qui regarde. Et ce principe, qui porte un nom précis en informatique, mérite d'être compris par quiconque gère un site aujourd'hui.
Une seule adresse, deux documents possibles
Le web repose sur un protocole appelé HTTP, qui règle les échanges entre un navigateur et un serveur. Dans ce protocole existe depuis toujours un mécanisme qu'on appelle la négociation de contenu. L'idée est simple : un serveur peut envoyer des versions différentes d'un même document selon ce que demande celui qui le consulte. Un exemple que tout le monde a déjà croisé sans y penser : un site propose sa page en français ou en anglais selon la langue du navigateur, sans changer l'adresse affichée dans la barre du haut. La page reste la même pour tout le monde dans son adresse, mais son contenu s'adapte à qui la demande.
Appliqué au GEO, le principe devient : à l'adresse d'une fiche produit, un navigateur humain reçoit la version riche, animée, pensée pour l'œil. Un robot de chatbot IA reçoit une version texte, structurée, pensée pour être lue et comprise en une seule passe, sans attendre qu'un script s'exécute. Même URL, deux documents. Le visiteur humain ne voit jamais la version texte. Le robot ne voit jamais le carrousel.
Une image aide à fixer l'idée. Imaginez un hôtel qui reçoit deux types de visiteurs à la même porte d'entrée : des clients, et un inspecteur de sécurité venu vérifier les issues de secours. Le personnel ne fait pas visiter la suite présidentielle à l'inspecteur. Il lui tend directement le plan d'évacuation, le rapport des dernières vérifications, les numéros de série des extincteurs. Même bâtiment, même porte, deux parcours pensés pour deux besoins différents. Un site qui pratique la négociation de contenu fait exactement ça : il identifie qui sonne à la porte, et adapte ce qu'il montre.
Pourquoi l'alternative ne tient pas
Avant que cette pratique existe, deux options s'offraient à un site qui voulait être lisible par les chatbots IA. La première : tout rendre côté serveur, c'est-à-dire construire la page complète, avec son contenu final, avant de l'envoyer à qui que ce soit, humain ou robot. Cette approche fonctionne, mais elle coûte cher en temps de développement sur les sites modernes construits autour du JavaScript, et elle ralentit l'affichage pour l'utilisateur humain qui attend sa page.
La deuxième option, plus répandue par défaut : ne rien faire, et laisser le robot se débrouiller avec une page à moitié vide. C'est ce qui arrive sur une quantité énorme de sites e-commerce ou de catalogues produits construits avec des outils modernes. Le résultat se voit dans les citations des chatbots IA : des marques absentes des réponses alors que leur contenu existe réellement, simplement parce que ce contenu n'a jamais atteint le robot qui aurait pu le lire.
La négociation de contenu règle ce dilemme sans sacrifier ni la vitrine humaine ni la lisibilité machine. On garde le site tel qu'il est, avec ses animations et son design, pour les visiteurs humains. On ajoute une couche qui intercepte les robots identifiés et leur sert une traduction en texte structuré de la même information. Personne ne perd rien.
Comment ça s'installe, concrètement
Techniquement, cette interception peut se faire à plusieurs endroits, et le choix dépend de l'infrastructure du site.
| Où ça s'installe | Ce que ça fait | Pour qui |
|---|---|---|
| Un intermédiaire chez l'hébergeur du trafic (type Cloudflare) | Intercepte la requête avant qu'elle n'atteigne le serveur, détecte le robot, lui renvoie le texte | Sites à fort trafic, besoin de rapidité |
| Un petit programme ajouté directement sur le serveur (PHP, Apache, nginx) | Même logique, mais gérée dans l'infrastructure existante du site | Sites sur hébergement classique, sans couche intermédiaire |
| Une règle intégrée au framework (Next.js et équivalents) | Le code de l'application elle-même décide, au moment de répondre, s'il doit renvoyer la page normale ou sa version texte | Sites construits avec un framework JavaScript moderne |
Dans tous les cas, le mécanisme de détection repose sur deux indices que le visiteur envoie sans même y penser : l'identité qu'il déclare (ce qu'on appelle le user-agent, une étiquette que chaque navigateur ou robot attache à sa requête pour se présenter) et parfois ce qu'il dit être capable de recevoir. GPTBot, PerplexityBot, ClaudeBot déclarent leur identité sans se cacher, par souci de transparence affiché par leurs éditeurs. Le serveur lit cette étiquette, et choisit la version à envoyer.
Ce qui change avec l'arrivée de cette brique dans les frameworks modernes comme Next.js, c'est la facilité d'installation. Il y a encore un an, mettre en place cette logique demandait souvent un développement sur mesure ou le passage par un intermédiaire externe. Aujourd'hui, elle peut s'écrire comme une règle de routage ordinaire dans le code même de l'application, au même endroit où on gère déjà la redirection d'une page qui n'existe plus ou le changement de langue. La barrière technique s'effondre, et ce qui relevait d'un projet d'infrastructure devient une ligne de configuration.
Le piège à éviter : une version texte qui raconte autre chose
Ce mécanisme ne vaut que si la version envoyée au robot dit la même chose que la version envoyée à l'humain. Le risque principal n'est pas technique, il est éditorial : laisser dériver les deux versions dans le temps. Une équipe met à jour le prix sur la page visible, oublie de régénérer la version texte, et le chatbot cite un tarif qui n'existe plus depuis trois mois. Un chatbot qui répète une information fausse parce que la source elle-même se contredit ne fait que son travail. La faute revient à celui qui a laissé deux versions d'une même vérité se désynchroniser.
Il y a aussi un piège plus retors : des faux robots. Rien n'empêche quelqu'un de modifier l'identité envoyée par son navigateur pour se faire passer pour GPTBot et accéder à la version texte, plus rapide à charger, plus simple à copier. La détection par la seule étiquette déclarée n'est donc jamais une sécurité absolue, elle reste un filtre de confort pour les robots légitimes, pas un verrou.
Enfin, la version texte doit rester fidèle au contenu, pas à sa mise en forme. Une tentation existe de profiter de cette version pour glisser des arguments commerciaux absents de la page visible, dans l'espoir d'influencer la réponse du chatbot. Cette pratique porte un nom : le cloaking, c'est-à-dire le fait de montrer aux robots un contenu différent de celui que voient les visiteurs. Google le définit comme le fait de présenter des contenus différents aux utilisateurs et aux moteurs de recherche dans le but de manipuler le classement et d'induire les utilisateurs en erreur, et le range parmi les pratiques visées par ses règles anti-spam : un site qui enfreint ces règles peut être moins bien classé, voire disparaître des résultats (Google Search Central, règles concernant le spam). La négociation de contenu reste légitime tant que les deux versions disent la même chose. Elle bascule dans le cloaking dès que la version servie aux robots raconte autre chose. Google précise aussi que ses règles visent les tentatives de manipuler les réponses générées par l'IA dans Google Search. Une marque qui fournit deux récits différents selon l'audience risque donc bien plus qu'elle n'y gagne.
Ce que ça déplace vraiment
La négociation de contenu ne rend pas une marque plus intéressante qu'elle ne l'est. Elle retire juste un obstacle purement technique entre un contenu qui existe déjà et un robot qui, sans elle, ne l'aurait jamais lu. C'est une différence de nature avec la plupart des leviers GEO : on ne travaille pas ici la qualité d'un argument ou la crédibilité d'une source, on travaille la tuyauterie qui permet à cet argument d'arriver jusqu'au lecteur automatisé.
Pour une marque dont le site repose lourdement sur du JavaScript, catalogue e-commerce en tête, c'est souvent le chaînon manquant entre un travail de fond déjà fait sur le contenu et une absence persistante dans les réponses des chatbots IA. Le texte est bon. Il n'a simplement jamais atteint sa destination.
Vurto installe cette négociation de contenu directement sur l'infrastructure du site, Cloudflare Worker, module PHP, Apache, nginx ou middleware Next.js selon la configuration existante, pour que chaque page continue de parler sa langue d'origine aux humains et sa langue structurée aux chatbots IA, sans jamais désynchroniser les deux.